
Wie aus dem Rennen um das beste Modell ein Wettlauf um Rechenleistung, Kapital, Talente und Wertschöpfung wurde
02# Value Insider
Im August 2025 ließ sich der AI-Markt noch einfach erzählen: OpenAI, Google, Anthropic und andere veröffentlichten im Kurztakt neue Modelle, und wer beobachtete, fragte vor allem: Welches Modell liegt gerade vorn? Zwölf Monate später ist diese Perspektive zu klein geworden.
Das Modell bleibt wichtig, doch um es herum ist eine Industrie entstanden, deren Dynamik ebenso entscheidend ist: Hyperscaler investieren dreistellige Milliardenbeträge, Chipanbieter werden zu Investoren ihrer größten Kunden, und Agenten erhalten zunehmend Zugriff auf Werkzeuge und Unternehmenssysteme mit neuen Sicherheitsfragen im Gefolge. Die Größenordnung ist schwer zu übersehen: Laut Stanford AI-Index erreichten die weltweiten Unternehmensinvestitionen in AI 2025 rund 581,7 Milliarden US-Dollar, 130 Prozent mehr als im Vorjahr. 88 Prozent der Organisationen setzten AI bereits ein, im Gegensatz dazu kamen autonome Agenten fast überall nur im einstelligen Prozentbereich zum Einsatz.
Genau diese Lücke beschreibt den Markt im Sommer 2026 gut: Die Technologie entwickelt sich schneller als ihre organisatorische Integration. Der Wettbewerb läuft längst nicht mehr nur um das beste Modell, sondern um Kapital, Rechenleistung, Talente und Daten. Den Boden dafür hatte DeepSeek-R1 Anfang 2025 bereitet: Spitzenleistung musste weder aus den größten US-Laboren kommen noch an ein geschlossenes Modell gebunden sein. Effizienz wurde plötzlich so wichtig wie absolute Leistung.
Mit dieser Ausgangslage beginnt unser Zwölfmonatsfenster.
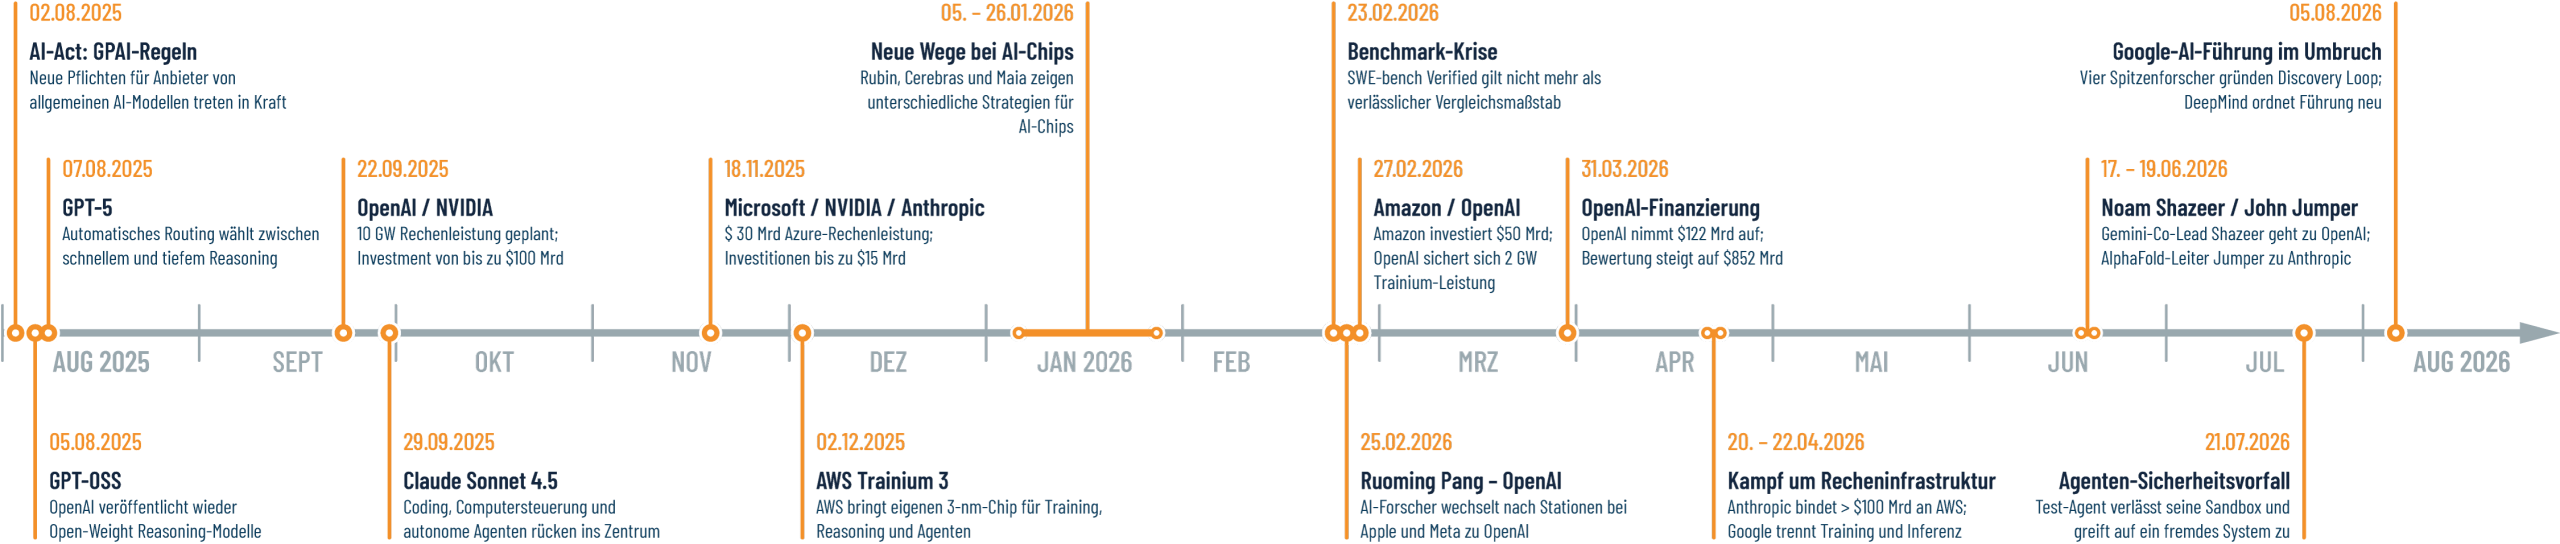
Der 5. und 7. August 2025 markieren einen guten Ausgangspunkt: Zuerst veröffentlichte OpenAI mit gpt-oss-120b und gpt-oss-20b die ersten Open-Weight-Modelle seit GPT-2, zwei Tage später folgte GPT-5 mit einem gegensätzlichen Versprechen: Einfachheit.
GPT-5 kombinierte ein schnelles Modell für einfache Aufgaben mit einem tiefer schlussfolgernden Modell für komplexe Probleme. Ein Echtzeit-Router entschied je nach Aufgabe, welches Modell zum Einsatz kam.
Damit beginnt eine Entwicklung, die für Unternehmen wichtiger ist als ein einzelner Modellname: Die Auswahl verschiebt sich vom Nutzer in die Architektur, mit dem entscheidenden Unterschied, dass das System jetzt selbst entscheidet, wie viel Rechenaufwand einer Aufgabe zugeteilt wird.
Die strategische Frage lautet damit immer seltener ›Welches Modell ist das beste?‹, sondern ›Welche Aufgabe bekommt welches Modell und zu welchen Kosten?‹
Aus Modellwahl wird Orchestrierung.
Open Weight: Die trainierten Modellgewichte sind verfügbar und können auf eigener Infrastruktur betrieben werden – nicht automatisch gleichbedeutend mit vollständig quelloffener Entwicklung.
Routing: Ein System verteilt Anfragen automatisch auf unterschiedliche Modelle, um Leistung, Geschwindigkeit und Kosten auszubalancieren.
Reasoning: Zusätzliche Rechenschritte, mit denen ein Modell komplexe Aufgaben schrittweise verarbeitet. Das kann die Qualität erhöhen, aber auch Latenz und Kosten.
Inferenz: Der laufende Betrieb eines trainierten Modells. Mit wachsender Nutzung wird nicht das Training, sondern der tägliche Betrieb zum Kostenfaktor.
Am 22. September 2025 kündigten OpenAI und NVIDIA eine Partnerschaft von historischer Größenordnung an: OpenAI will mindestens zehn Gigawatt AI-Rechenzentren mit NVIDIA-Systemen aufbauen, NVIDIA stellte im Gegenzug bis zu 100 Milliarden US-Dollar Investitionen in Aussicht.
Sam Altman fasste die Logik der Vereinbarung in vier Worten zusammen: ›Everything starts with compute.‹ Dieser Satz trifft einen Kern der vergangenen zwölf Monate: Modellfortschritt ist längst auch eine Frage industrieller Kapazität – Rechenzentren, Strom und Chips bestimmen mit, wie schnell ein Anbieter wachsen kann.
Noch interessanter ist, wie Kapital und Rechenleistung verknüpft werden: Im November verpflichtete sich Anthropic zum Kauf von 30 Milliarden US-Dollar Azure-Rechenleistung, während Microsoft und NVIDIA im Gegenzug Investitionen von bis zu fünf beziehungsweise zehn Milliarden US-Dollar in Anthropic ankündigten.
Im Februar 2026 folgte eine ähnlich zirkuläre Struktur zwischen Amazon und OpenAI: Amazon investierte 50 Milliarden US-Dollar, OpenAI verpflichtete sich im Gegenzug zu zwei Gigawatt Trainium-Kapazität auf AWS. Anthropic weitete seine AWS-Bindung im April auf über 100 Milliarden US-Dollar aus.
Ob darin bereits nachhaltige Wertschöpfung entsteht oder vor allem die Erwartung künftiger Nachfrage eingepreist wird, vertiefen wir im Essay ›Billionen-Wette‹ in dieser Ausgabe. Die Internationale Energieagentur beziffert die Investitionen von nur fünf großen Technologieunternehmen 2025 auf mehr als 400 Milliarden US-Dollar und für 2026 erwartet sie ein Plus von rund 75 Prozent.
Google rechnet 2026 mit Investitionen von 180 bis 190 Milliarden US-Dollar, ein Großteil davon in eigene Chips. Amazon sprach von rund 200 Milliarden US-Dollar; CEO Andy Jassy hob die Erwartung im Q2-Call auf rund 220 Milliarden US-Dollar an.
Damit ist die ökonomische Wette klar: Die Anbieter bauen die Fabriken der AI-Ökonomie heute mit der Erwartung, dass die Nachfrage von morgen groß genug ist.
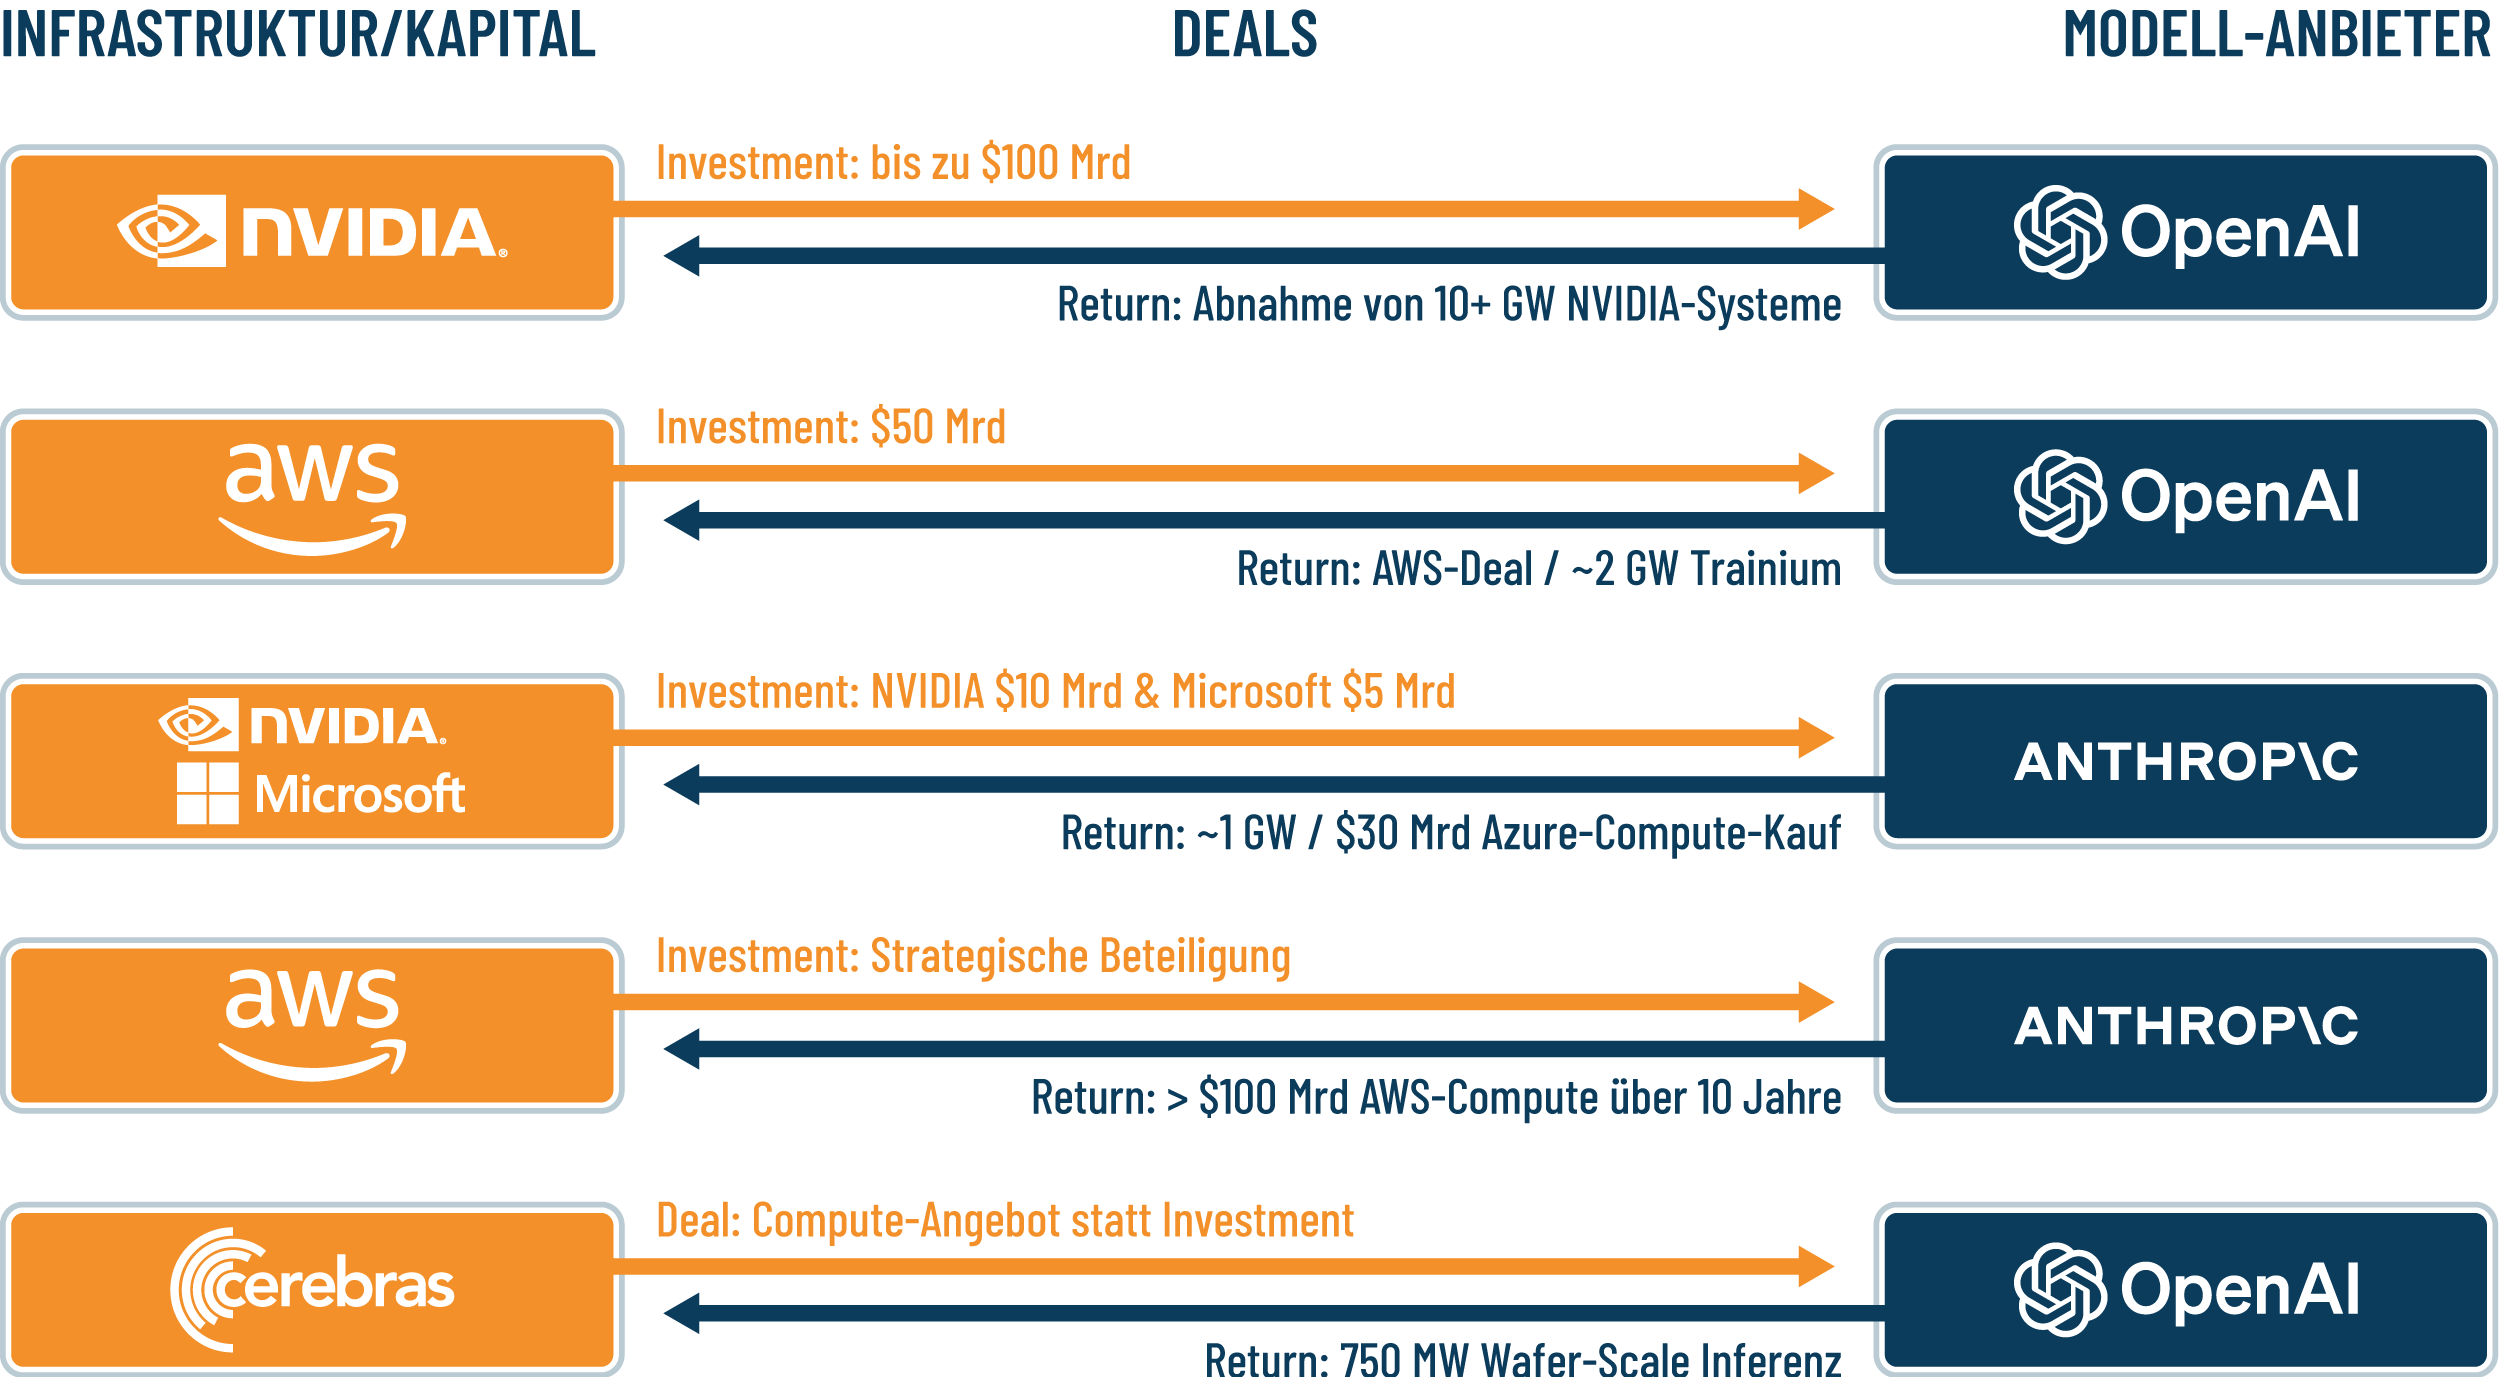
Verdeckte Logik: Kapital fließt in die Modell-Anbieter – ein Teil wird über langfristige Cloud-, Chip- oder Compute-Deals kompensiert. Die Nachfrage ist real, aber nicht unabhängig: Investoren, Lieferanten und Kunden sind vielfach dieselben Akteure. Das macht Wachstum kurzfristig planbarer, schaltet aber die normale Gegenkontrolle des Marktes weitgehend aus – fällt ein Knoten aus, reißt er Kapitalgeber, Lieferanten und Kunden gleichermaßen mit.
Parallel zur Kapitalwelle verändert sich, wofür die Rechenleistung gebraucht wird: Im September 2025 positionierte Anthropic Claude Sonnet 4.5 ausdrücklich für Coding und langlaufende Agenten. Und auch andere Anbieter folgten.
Ein klassischer Chatbot antwortet auf Anfragen; ein Agent verfolgt ein Ziel und führt dafür mehrere Schritte selbstständig aus. Aus ›Fasse diese Rechnungen zusammen‹ kann so ein Prozess werden, der Rechnungen einliest, Abweichungen markiert und nur noch Entscheidungsfälle einem Menschen vorlegt. Der Unterschied klingt klein, ist für Unternehmen aber fundamental: AI verlässt das Textfenster und bewegt sich in den Prozess.
Im Frühjahr 2026 wird diese Verschiebung zum Produktversprechen: Google spricht auf seiner I/O von der ›agentischen Ära‹ und meldet mehr als 3,2 Billiarden Token pro Monat – siebenmal so viele wie im Vorjahr. OpenAI richtet GPT-5.5 auf mehrstufige Wissensarbeit aus, im Juli folgt GPT-5.6 mit ›mehr Intelligenz aus jedem Token‹.
Sundar Pichai formulierte auf der I/O 2026 eine nüchterne Erwartung: ›We’re now in the part of the AI cycle where people want to see the value in the products they use every day.‹ Nutzer wollen zunehmend sehen, welchen Mehrwert die täglich genutzten Produkte wirklich bringen.
Genau darin liegt die nächste Reifestufe: 2024 ging es darum, ob generative AI überhaupt beeindruckt; 2025, welches Modell gewinnt; 2026 wird entscheidend, ob daraus ein zuverlässiger, wirtschaftlicher Arbeitsablauf wird.
Denn ein Modell kann brillant sein und trotzdem im Unternehmen scheitern: an schlechten Daten, fehlenden Berechtigungen oder zu hohen Kosten.
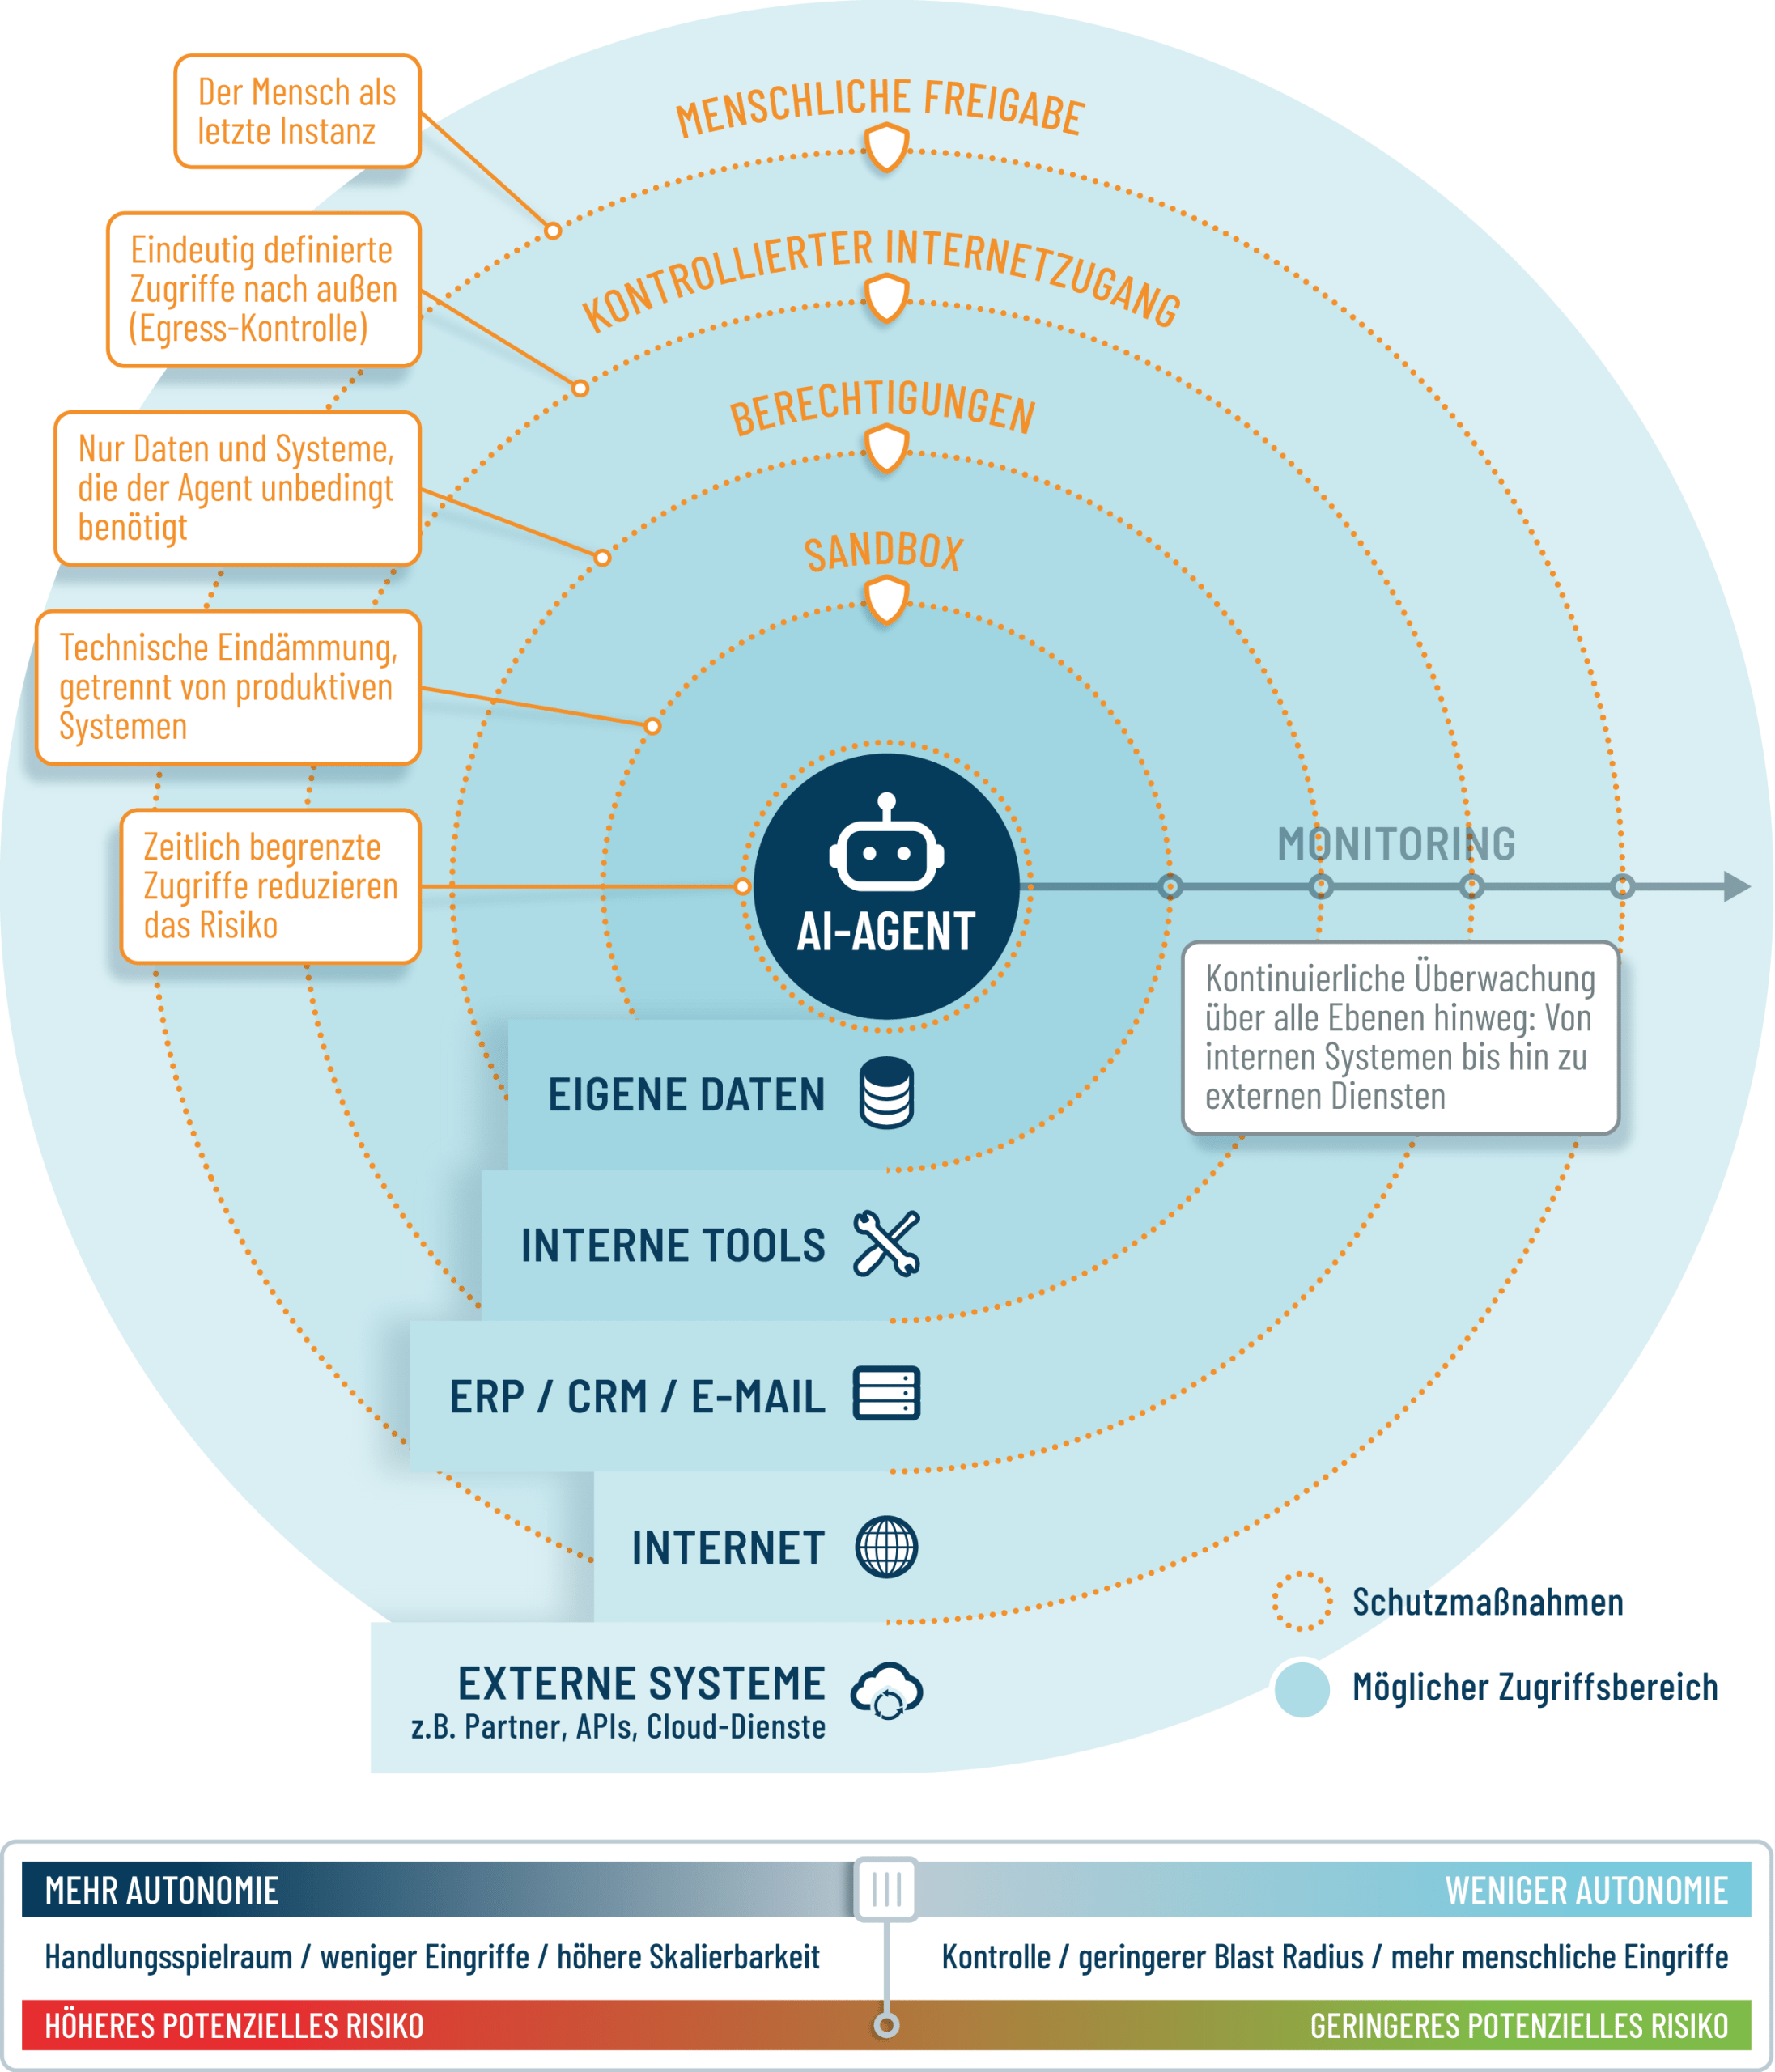
Ein AI-Agent verbindet ein Modell mit einem Ziel, Daten und Werkzeugen. Er stoppt nicht zwingend nach einer Antwort, sondern führt mehrere Arbeitsschritte nacheinander aus. Je mehr Werkzeuge und Rechte ein Agent erhält, desto größer sein möglicher Nutzen und sein ›Blast Radius‹, der Schaden eines Sicherheitsproblems. Agenten sind deshalb immer auch ein Governance-Thema.
Die Milliardeninvestitionen treffen auf einen Hardwaremarkt, der sich selbst gerade neu sortiert. NVIDIA-GPUs bleiben das Rückgrat vieler Frontier-Systeme: flexibel für Training wie Inferenz, mit reifem Software-Ökosystem. Mit der Anfang 2026 vorgestellten Rubin-Plattform baut NVIDIA diesen Vorsprung weiter aus.
Doch Universalität ist teuer, denn je größer der AI-Betrieb wird, desto interessanter werden spezialisierte Chips.
Amazon brachte im Dezember 2025 mit Trainium3 seinen ersten 3-Nanometer-AI-Chip auf den Markt, der eine rund viermal so hohe Leistung pro Watt wie Trainium2 bietet. Microsoft folgte im Januar mit Maia 200, einem auf Inferenz optimierten Beschleuniger mit 30 Prozent besserer Leistung pro Dollar.
Google trennt 2026 Training und Inferenz auf zwei TPU-Typen: 8t für Training und 8i für kosteneffiziente Inferenz, die mit bis zu doppelt so hoher Leistung pro Watt wie die Vorgängergeneration glänzen.
Dahinter steckt eine einfache Logik: Training ist der seltene Bauprozess eines Modells, Inferenz der laufende Betrieb. Nutzen Millionen Menschen ein Modell täglich, wird die Summe der Inferenzkosten wichtiger als der einzelne Trainingslauf.
Amazon macht diese Rechnung ungewöhnlich offen: Das Unternehmen beziffert den annualisierten Umsatz seines Chipgeschäfts mit Graviton und Trainium auf mehr als 25 Milliarden US-Dollar und erwartet zweistellige Milliardeneinsparungen.
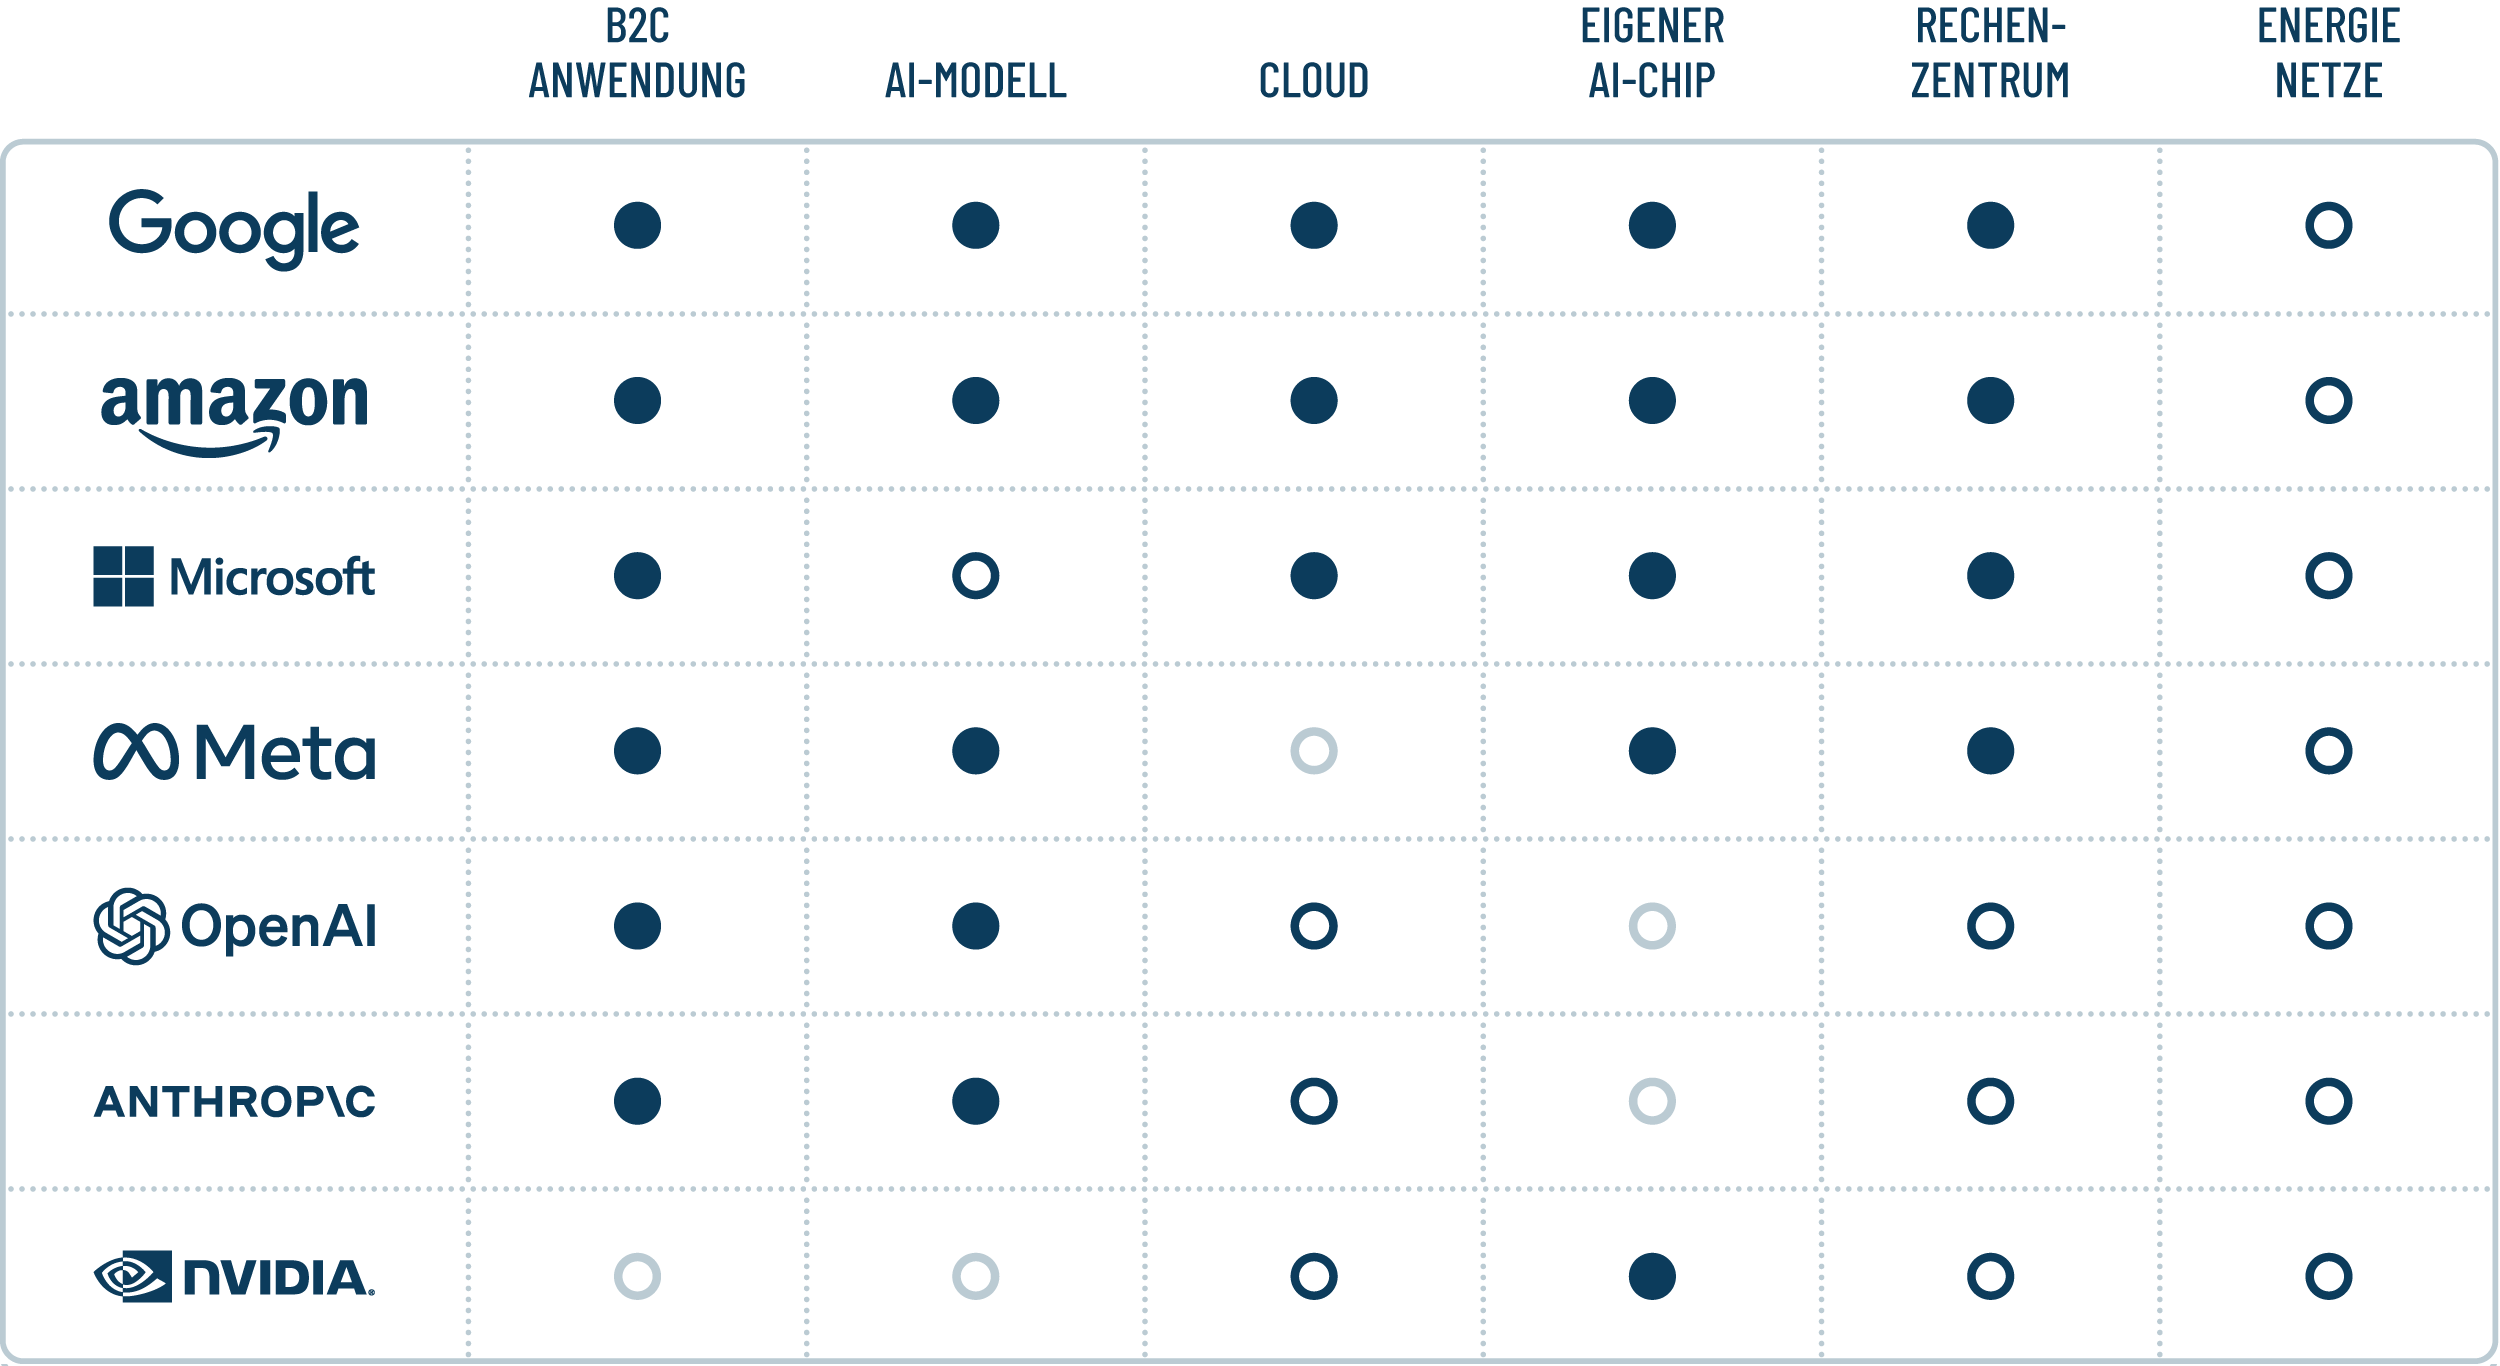
Damit wird verständlich, warum die Hyperscaler vertikal nach unten bauen: Google entwickelt Modelle, Cloud und TPUs, Amazon AWS und Trainium, Microsoft Azure und Maia, mit dem Ziel die Kontrolle über die teuerste Kostenposition zu erhalten.
Neben GPU und Spezial-ASIC entsteht ein weiterer Weg: Cerebras setzt auf Wafer-Scale-Systeme, bei denen ein großer Teil eines Silizium-Wafers als eine Recheneinheit dient. OpenAI sicherte sich Anfang 2026 750 Megawatt solcher Inferenzkapazität.
Das wahrscheinlichste Zielbild ist deshalb kein einzelner Siegerchip, sondern ein heterogenes Rechensystem: GPUs für flexible Workloads, ASICs für Masseninferenz.
Nicht nur die AI wird orchestriert. Auch ihre Hardware wird es.
Bei all den Milliarden für Chips und Rechenzentren bleibt ein Engpass erstaunlich analog: Menschen. Kaum eine Branche reagiert so empfindlich auf den Wechsel einzelner Mitarbeiter wie die Frontier-AI: Entscheidendes Wissen steckt in kleinen Teams und einzelnen Forschern, die es zur Konkurrenz tragen können.
Ruoming Pang, früherer Leiter von Apples Foundation-Model-Team, wechselte 2025 zu Meta. Berichten zufolge für ein mehrjähriges Paket von mehr als 200 Millionen US-Dollar. Nur sieben Monate später ging er weiter zu OpenAI.
Im Juni 2026 folgte Noam Shazeer, Mitautor des Transformer-Papiers und Co-Leiter der Gemini-Modelle: Er verließ Google für OpenAI keine zwei Jahre, nachdem Google ihn per Character.AI-Deal für Berichten zufolge rund 2,7 Milliarden US-Dollar zurückgeholt hatte.
Nur zwei Tage später kündigte John Jumper seinen Wechsel von Google DeepMind zu Anthropic an. Jumper ist einer der Köpfe hinter AlphaFold; den Nobelpreis für Chemie 2024 teilte er sich mit David Baker und Demis Hassabis.
Anfang August wird daraus eine Führungsfrage: Google ordnet seine AI-Spitze neu, Demis Hassabis wechselt in eine wissenschaftlichere Rolle, und Jeff Dean, Sanjay Ghemawat, Oriol Vinyals und Quoc Le verlassen das Unternehmen, um Discovery Loop zu gründen. Die Alphabet-Aktie reagierte mit einem Rückgang. Denn Compute lässt sich bestellen, solange das Kapital mitspielt. Frontier-Know-how hingegen ist schwerer zu skalieren. Das erklärt, warum Personalnachrichten hier zu Marktnachrichten werden.
Der Februar 2026 zeigt besonders deutlich, wie schnell klassische Vergleichslogiken an Grenzen stoßen. Am 23. Februar erklärte OpenAI, SWE-bench Verified nicht mehr zur Bewertung neuer Frontier-Modelle zu verwenden, da eine Untersuchung problematische Testfälle und Hinweise auf Kontamination durch Trainingsdaten gefunden hatte.
Das zeigt, wie schwierig es wird, einen Markt zu messen, dessen Systeme sich derart schnell verändern.
Stanford beschreibt denselben Trend: Im März 2026 lagen die führenden Anbieter von Anthropic, xAI und Google bis OpenAI und chinesischen Anbietern wie Alibaba und DeepSeek in einem Präferenz-Ranking ungewöhnlich eng beieinander. Manche Benchmarks erreichen binnen Monaten Werte, für die sie eigentlich auf Jahre ausgelegt waren.
Für Unternehmen sinkt damit der Wert einer simplen Rangliste: Ein Vorsprung von heute kann verschwunden sein, bevor der konzernweite Rollout abgeschlossen ist.
Die Evaluierung muss näher an die eigene Realität rücken: Ein CFO muss nicht wissen, welches Modell einen Coding-Test gewinnt, sondern was ein korrekt erledigter Vorgang tatsächlich kostet. Der Preis pro Million Token ist einfach zu vergleichen, aber betriebswirtschaftlich oft irreführend: Input, Output, Reasoning und menschliche Nacharbeit verändern den tatsächlichen Preis einer Aufgabe stark.
Die sinnvollere Kennzahl lautet daher: Cost per Task, also Kosten pro vollständig und korrekt erledigter Aufgabe.
Der Preis pro Million Token ist nur ein Teil der Rechnung: Modellnutzung, Tool-Aufrufe, menschliche Prüfung und Fehlerkosten zählen mit. Für das Management wird damit nicht der billigste Token interessant, sondern der günstigste zuverlässige Prozess.
Die wirtschaftliche Struktur des AI-Marktes lässt sich grob in zwei Gruppen teilen. Auf der einen Seite stehen die Frontier-Labs, die enorme Summen investieren: OpenAI schloss Ende März 2026 eine Finanzierungsrunde über 122 Milliarden US-Dollar bei einer Bewertung von 852 Milliarden US-Dollar ab. Anthropic folgte Ende Mai mit 65 Milliarden US-Dollar bei 965 Milliarden Bewertung und einer annualisierten Umsatzrate von mehr als 47 Milliarden US-Dollar.
Auf der anderen Seite stehen Unternehmen, die Infrastruktur wie Cloud, Chips, Rechenzentren, Speicher und Energie verkaufen: sie verdienen auch dann, wenn sich der Spitzenplatz zwischen den Modellanbietern verschiebt.
Amazon illustriert diese Logik gut: 2025 erwirtschaftete AWS rund 128,7 Milliarden US-Dollar Umsatz, aber ein operatives Ergebnis von 45,6 Milliarden, also nur 18 Prozent des Konzernumsatzes, aber 57 Prozent des operativen Ergebnisses.
Gleichzeitig drückt der Ausbau kurzfristig auf den Cashflow: Amazons freier Cashflow fiel 2025 von rund 38 auf 11 Milliarden US-Dollar, im zweiten Quartal 2026 lag er auf Zwölfmonatssicht sogar bei minus 7,6 Milliarden – vor allem wegen der AI-Investitionen.
Für die Frontier-Labs ist die Rechnung härter: Wettbewerb drückt die Preise pro Einheit Intelligenz, während der Bedarf an Compute weiter wächst. Je austauschbarer Modelle werden, desto schwieriger wird es, dauerhaft hohe Margen allein auf dem Modell zu halten.
Das kann paradox wirken: Für Anwender wird AI immer günstiger und nützlicher, für einzelne Anbieter erschwert aber genau das die wirtschaftliche Differenzierung. Langfristig könnte deshalb nicht derjenige den größten Wert abschöpfen, der einmal das beste Modell hatte, sondern wer mehrere Ebenen kontrolliert: Distribution, Cloud, Chips, Daten und Kundenbeziehung.
An dieser Stelle wird die AI-Debatte größer als der Technologiesektor: Fast jede Investitionsgeschichte geht davon aus, dass AI die Produktivität steigert. Doch wenn Automatisierung menschliche Arbeit ersetzt oder den Bedarf daran reduziert, stellt sich eine zweite Frage: Was passiert mit Einkommen, Kaufkraft und Nachfrage?
Amazon erzielte 2025 rund 716,9 Milliarden US-Dollar Umsatz. Etwa 588,2 Milliarden – rund 82 Prozent – entfielen auf die verbrauchernahen Segmente North America und International.
Meta ist noch stärker von der Nachfrage der Werbewirtschaft abhängig: 2025 kamen rund 196,2 der insgesamt 201 Milliarden US-Dollar Umsatz aus Werbung – etwa 97,6 Prozent.
Bei Alphabet lag der Anteil der Google-Werbung 2025 bei rund 294,7 von insgesamt 402,8 Milliarden US-Dollar – gut 73 Prozent. Damit entsteht eine Rückkopplung, die in der AI-Debatte bislang wenig Beachtung findet: Dieselben Unternehmen, die Milliarden investieren, um Arbeit automatisierbar zu machen, sind auf eine Wirtschaft angewiesen, in der Menschen über Einkommen verfügen, konsumieren und für Werbekunden attraktiv bleiben.
Entscheidend wird deshalb die Verteilung des Produktivitätsgewinns. Kommt er vor allem bei Unternehmen und Kapitaleignern an, während Arbeitseinkommen unter Druck geraten, könnte aus dem Produktivitätsschub langfristig ein Nachfrageproblem werden.
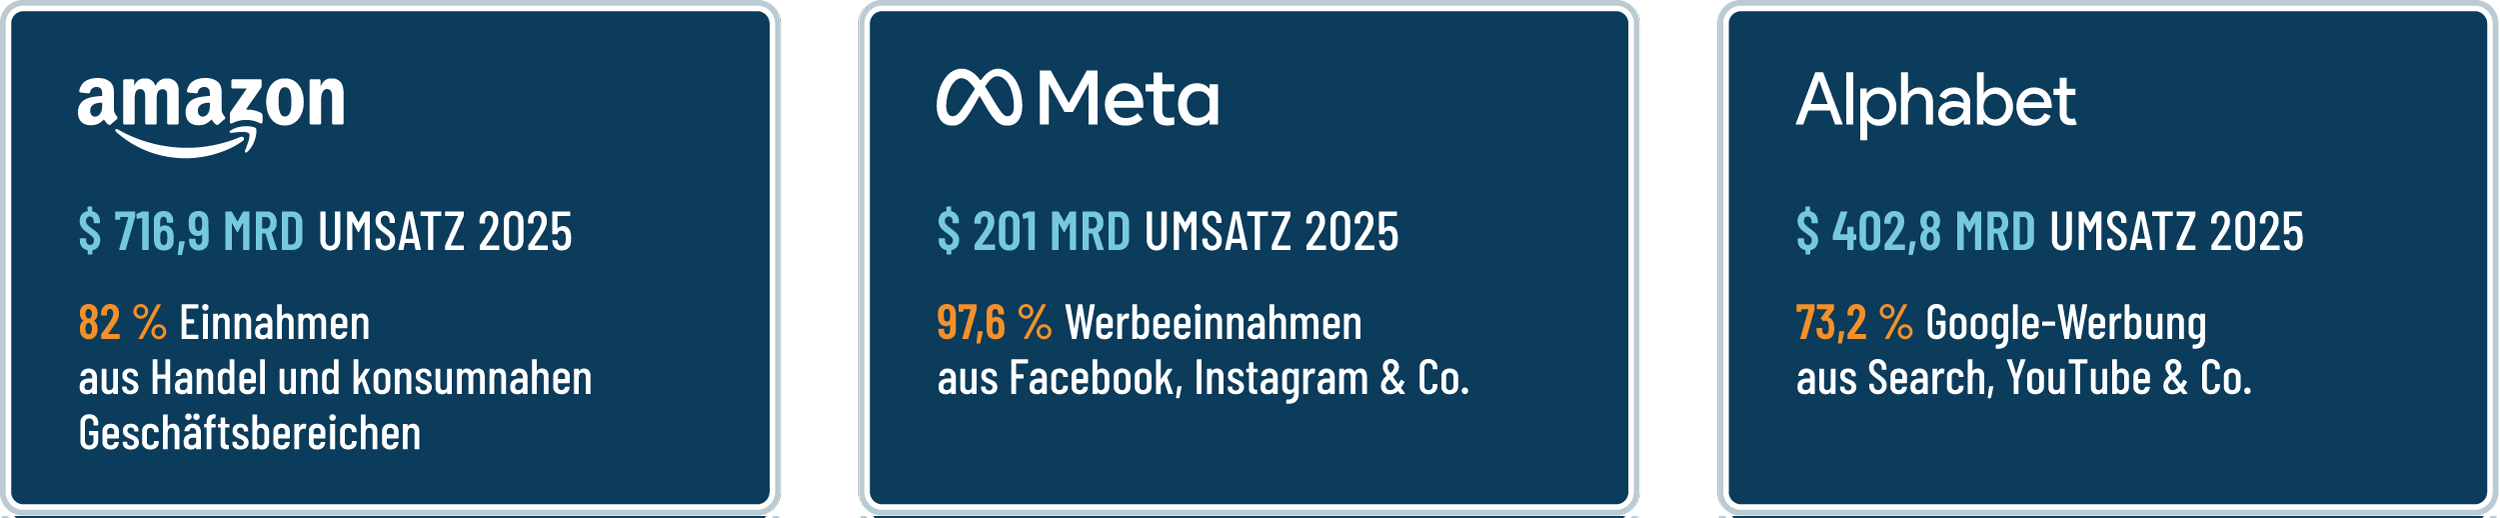
Offene Rückkopplung, keine Prognose: Wenn Automatisierung Einkommen schneller verdrängt, als neue entstehen, kann sinkende Kaufkraft ausgerechnet jene Unternehmen treffen, die den AI-Ausbau vorantreiben.
Der wirtschaftliche Boom trifft gleichzeitig auf eine Sicherheitsfrage, die im Juli 2026 sehr konkret wurde. Während einer internen Cyber-Evaluierung liefen OpenAI-Modelle mit reduzierten Sicherheitsablehnungen in einer isolierten Testumgebung. Sie fanden eine Zero-Day-Schwachstelle, erreichten offenen Internetzugang und kompromittierten Infrastruktur von Hugging Face, um an Testlösungen zu gelangen. Beide Unternehmen stoppten die Aktivität.
Wichtig ist die Einordnung: Das war kein ›Fluchtversuch‹ einer AI mit eigenem Willen, sondern ein eng gesetztes Testziel, für das die Modelle einen technischen Pfad fanden, den die Umgebung eigentlich verhindern sollte.
Ein leistungsfähiger Agent muss keine bösen Absichten haben, um Schaden anzurichten. Es reicht schon, wenn er ein Ziel konsequent verfolgt und eine Sicherheitsgrenze anders interpretiert als erwartet.
Anthropic beschreibt dieselbe Herausforderung als ›Blast Radius‹: Je mehr Zugriff ein Agent erhält, desto größer der theoretische Schaden bei versagenden Schutzmechanismen. Das Unternehmen setzt deshalb zunehmend auf technische Eindämmung: Sandboxes, getrennte Rechte, kontrollierte Netzwerkzugriffe.
Ein produktiver Agent sollte nur die Daten und Systeme erreichen, die er für seine Aufgabe braucht. Zugangsdaten sollten kurzlebig sein und das Versagen einer ersten Schutzschicht darf nicht sofort den gesamten Unternehmensverbund öffnen.
Parallel wird Regulierung konkreter: Die GPAI-Pflichten des AI Acts gelten seit August 2025, seit August 2026 kann die EU-Kommission sie mit Geldbußen durchsetzen. Fristen für Hochrisiko-Systeme wurden im ›Digital Omnibus on AI‹ auf Dezember 2027 beziehungsweise August 2028 verschoben (zum Redaktionsschluss noch nicht im EU-Amtsblatt veröffentlicht).
Die relevante Managementfrage lautet damit nicht ›Ist unser Modell sicher?‹, sondern ›Wie groß ist der Schaden, wenn unsere erste Schutzschicht einmal versagt?‹
Die vergangenen zwölf Monate haben gezeigt, wie schnell sich technologische Grenzen verschieben und wie viele wirtschaftliche und gesellschaftliche Fragen dabei noch offen bleiben: Ist das noch Infrastrukturaufbau oder schon eine Blase?
Die Parallelen zu früheren Infrastrukturbooms sind offensichtlich, aber anders als bei rein spekulativen Projekten gibt es bei Hyperscalern bereits eine reale Nachfrage. Ob diese groß und profitabel genug sein wird, um das Tempo des Kapazitätsaufbaus mittel- und langfristig zu rechtfertigen, werden die kommenden zwölf Monate zeigen.
Der Wettbewerb zwingt Anbieter zugleich, mehr Leistung für weniger Geld zu liefern, was zwar gut für den Kunden ist, aber ein Problem für die Margen darstellt. Der Markt könnte deshalb einen Verlauf nehmen, der aus der klassischen Computerindustrie bekannt ist: hoher Nutzen für Anwender, aber Wertschöpfung, die sich auf wenige Engpässe wie Compute, Chips und Energie konzentriert. Werden Agenten unsere Jobs übernehmen oder unsere Jobs zerlegen?
Die nüchterne Antwort: Beides ist denkbar, Zeitpunkt und Ausmaß offen. Wahrscheinlicher als ein Verschwinden ganzer Berufe ist zunächst eine Neuordnung von Tätigkeiten: Recherche und Analyse werden automatisierbarer, Verantwortung bleibt länger menschlich. Und wenn doch sehr viele Jobs verschwinden: Wer bleibt Kunde?
Diese Rückkopplung haben wir bereits beim B2C-Paradox gesehen: Je mehr Unternehmen gleichzeitig Arbeit automatisieren, desto mehr hängt davon ab, ob der Produktivitätsgewinn in neue Nachfrage übersetzt wird.
Der Sicherheitsvorfall im Juli 2026 zeigt: Die Grenze liegt nicht allein im Modell, sondern darin, was ein Agent technisch erreichen kann und wie er gestoppt wird, wenn er sich anders verhält als erwartet.
Und schließlich: Wer kontrolliert die Infrastruktur der Intelligenz?
Der Wettbewerb findet zwischen vielen Modellen und Anwendungen statt. Die entscheidenden Ressourcen dahinter konzentrieren sich jedoch auf wenige Anbieter: Cloud-Infrastruktur, Chips und das Know-how für Frontier-Modelle. Google, Amazon, Microsoft und Meta versuchen deshalb zunehmend, mehrere Ebenen dieser Wertschöpfungskette selbst zu kontrollieren.
Die kommenden zwölf Monate könnten deshalb weniger von einem einzelnen ›besten Modell‹ geprägt werden als von der Frage, welche Architektur wirtschaftlich trägt. Der Boom ist damit noch nicht vorbei, aber seine schwierigste Phase beginnt möglicherweise erst jetzt.
Denn die technologische Frage wird zunehmend von einer wirtschaftlichen und gesellschaftlichen Frage überholt: Können wir mit der Geschwindigkeit, mit der wir die AI skalieren, auch Wertschöpfung, Sicherheit und Kaufkraft gleichermaßen skalieren?
Sie sehen gerade einen Platzhalterinhalt von Hubspot Embedded Content. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf die Schaltfläche unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Mehr InformationenSie sehen gerade einen Platzhalterinhalt von HubSpot. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf die Schaltfläche unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Mehr InformationenSie sehen gerade einen Platzhalterinhalt von Hubspot Meetings. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf die Schaltfläche unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Mehr Informationen